Architecture Lambda pour le Traitement Temps Réel et Batch des Flux Wikipédia
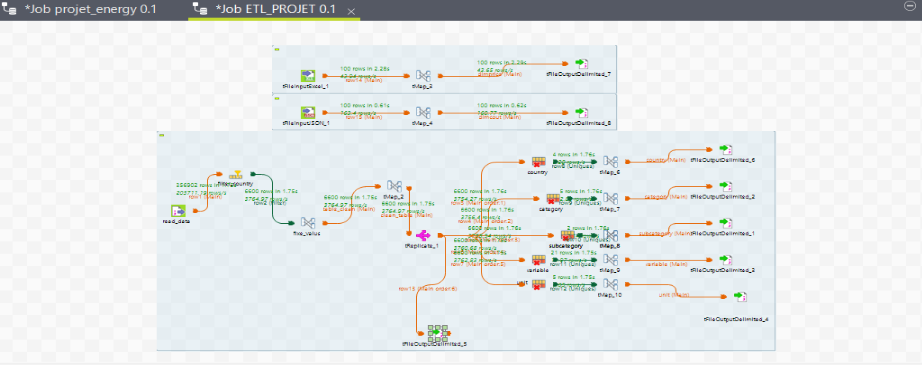
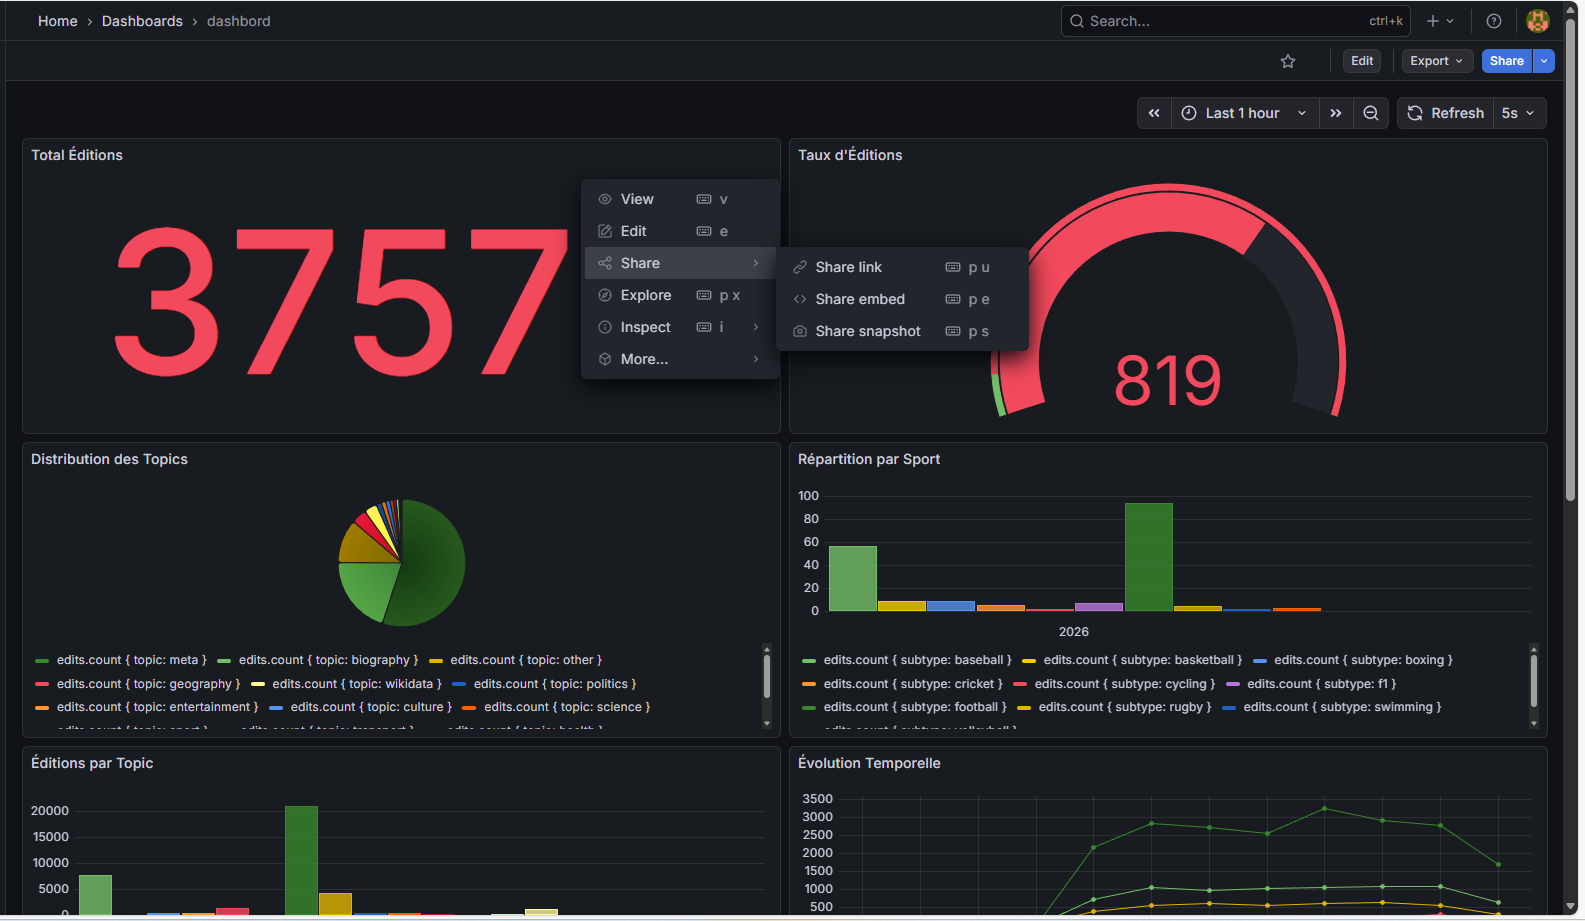
Conception et développement d’un pipeline Big Data basé sur les flux d’événements Wikipedia (SSE) et Apache Kafka. Le projet repose sur une architecture Lambda combinant une Speed Layer avec InfluxDB et Grafana pour le stockage des données temporelles et la visualisation des événements en temps réel, ainsi qu’une Batch Layer avec HDFS et Streamlit pour le stockage des données historiques et leur analyse interactive.